📦 DVC aplica las buenas prácticas de Git a los datos, modelos y experimentos de ciencia de datos. Su objetivo es hacer que los proyectos de Machine Learning sean reproducibles y fáciles de compartir.
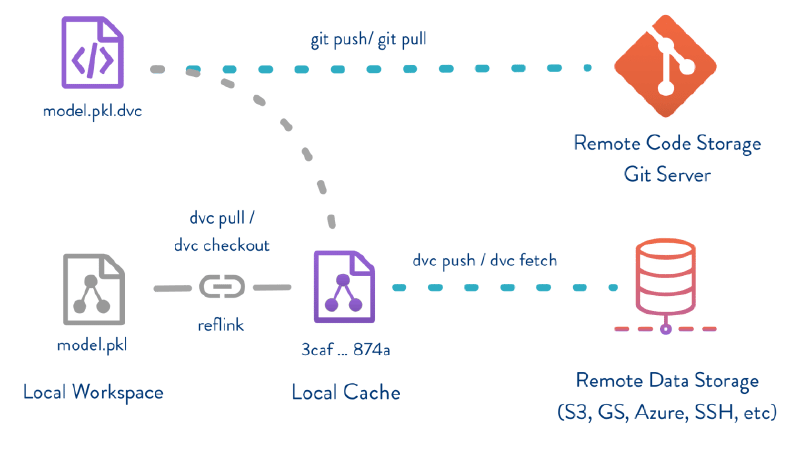
🔗 Los archivos grandes no tienen que vivir dentro del repositorio Git. DVC conserva sus versiones y metadatos en el proyecto, mientras almacena los datos en una caché local o en remotos como S3, Azure, Google Cloud o servidores propios.
⚙️ También permite describir pipelines conectando código, datos, comandos y resultados. Cuando algo cambia, solo se ejecutan los pasos afectados. Además, los experimentos pueden correrse, compararse y compartir sus métricas sin necesidad de un servidor central.
El autor presenta una experiencia similar a combinar Git para datos, Makefiles para pipelines y un sistema local de seguimiento de experimentos. DVC funciona desde la línea de comandos y ofrece una extensión para VS Code.
💡 Explicación en pocas palabras#
Git guarda muy bien el código, pero los datasets y modelos suelen ser demasiado grandes. DVC guarda una referencia ligera en Git y mantiene los archivos pesados fuera del repositorio, permitiendo volver a cualquier versión y reproducir cómo se obtuvo un resultado.
Más información en el link 👇
