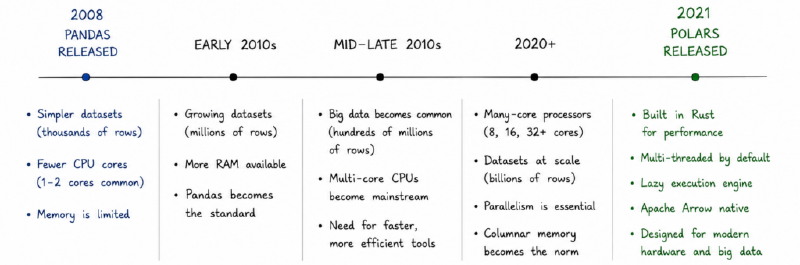
Pandas lleva más de una década como estándar para limpiar, explorar y preparar datos. Polars aparece como alternativa diseñada para el hardware moderno: aprovecha varios núcleos, usa ejecución perezosa y almacena datos en formato columnar Apache Arrow. ⚡
Por eso suele ser más rápido, especialmente con grandes volúmenes y transformaciones complejas. Su ejecución lazy construye un plan y lo optimiza antes de materializarlo, evitando trabajo innecesario y reduciendo movimientos en memoria.
💡 Explicación en pocas palabras#
Pandas ejecuta normalmente cada operación al instante y es muy cómodo para notebooks, aprendizaje y conjuntos pequeños. Polars se parece en su sintaxis, pero funciona como un planificador: reúne las operaciones, las optimiza y las reparte entre núcleos cuando conviene.
No hay que elegir un ganador absoluto. Pandas tiene un ecosistema enorme y compatibilidad amplia con visualización y machine learning. Polars brilla cuando el tamaño, la complejidad o el tiempo de preprocesamiento se convierten en un cuello de botella. Ambos pueden convivir: explorar con Pandas y producir con Polars.
Más información en el link 👇