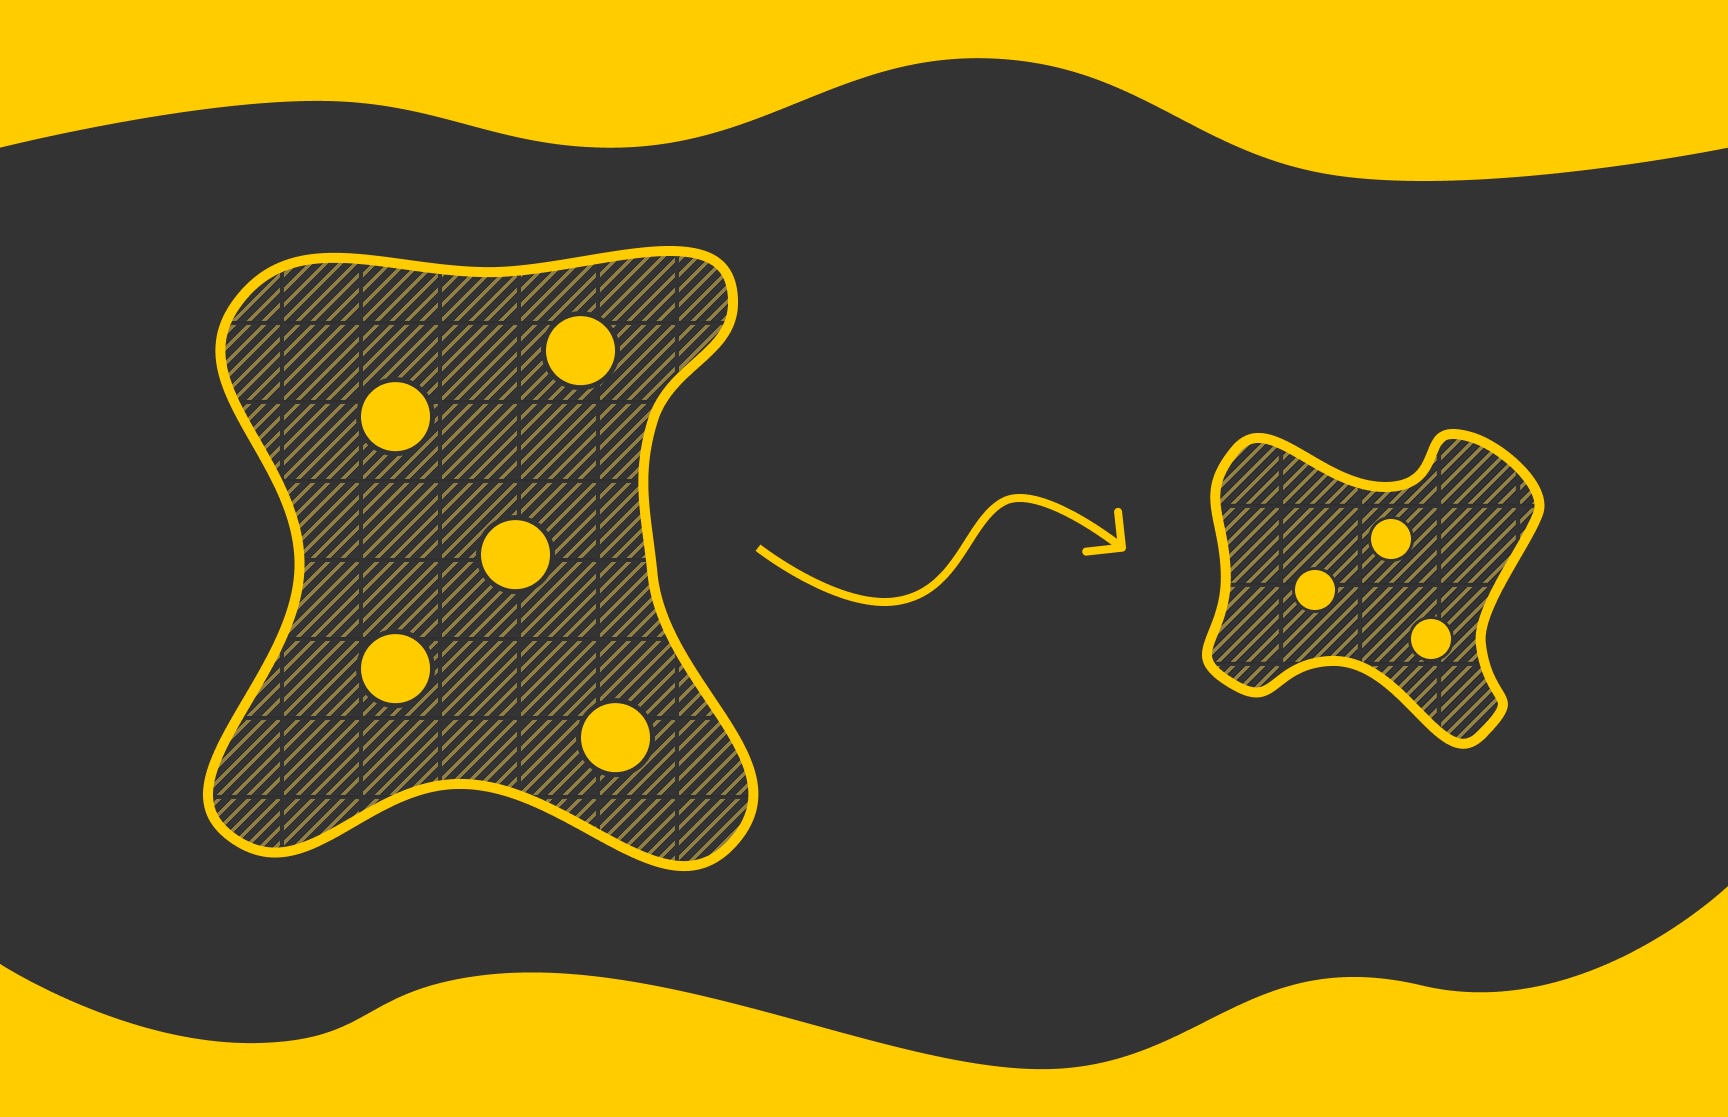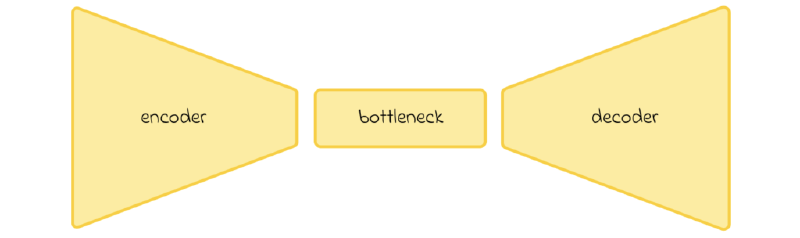
Los autoencoders son redes neuronales que aprenden a comprimir información y luego reconstruirla. Su arquitectura tiene tres piezas: un codificador, que reduce los datos; un cuello de botella, donde queda la representación comprimida; y un decodificador, que intenta recuperar la entrada original. 🧠
Durante el entrenamiento no necesitan etiquetas: el modelo compara la imagen reconstruida con la original y ajusta sus pesos mediante la pérdida de reconstrucción, normalmente el error cuadrático medio (MSE). El objetivo es conservar las características importantes usando muchos menos valores. Por ejemplo, Stable Diffusion comprime imágenes de 512 × 512 × 3 a 64 × 64 × 4, una reducción de 48 veces. 📉
💡 Explicación en pocas palabras#
Imagina una maleta: el codificador guarda lo esencial, el espacio latente es la maleta compacta y el decodificador intenta reconstruir lo que había dentro. Si la maleta es demasiado pequeña, se pierde información; si es demasiado grande, apenas hay compresión.
Los autoencoders también pueden eliminar ruido, completar partes faltantes de una imagen o borrar objetos. Sin embargo, el MSE puede producir bordes borrosos, por lo que las variantes avanzadas usan pérdidas más adecuadas para la percepción humana.
Más información en el link 👇