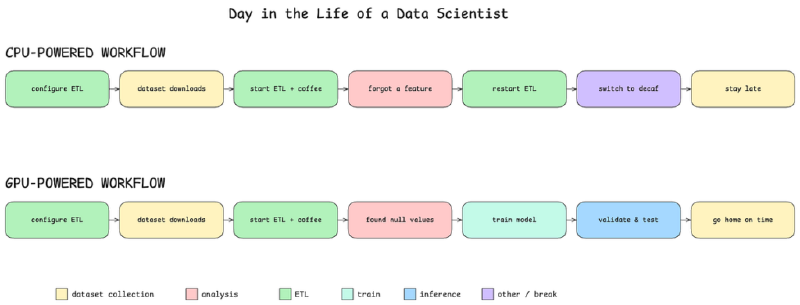
⚡ Muchas tareas de ciencia de datos trabajan con tablas y siguen ejecutándose en la CPU. Cuando crecen los datos, operaciones como filtros, joins, agrupaciones y ordenamientos pueden convertirse en el cuello de botella.
El ecosistema RAPIDS permite mover estos flujos a la GPU con cambios pequeños. cuDF ofrece una API parecida a pandas para crear DataFrames que ejecutan operaciones en la tarjeta gráfica. Para código pandas existente, cudf.pandas intenta ejecutar cada operación en GPU y vuelve automáticamente a la CPU cuando algo no es compatible.
También Polars puede usar un motor GPU basado en cuDF. Su API Lazy construye un plan optimizado y decide si ejecutarlo en GPU o CPU; incluso puede distribuirlo entre varias GPU con Ray.
🚦 No todo mejora al usar una GPU. En datasets pequeños, el coste de transferir datos puede superar la ganancia. Además, las funciones Python personalizadas suelen provocar fallback a CPU. Por eso conviene perfilar el flujo y medir antes de migrar.
💡 Explicación en pocas palabras#
Una GPU tiene miles de núcleos capaces de realizar muchas operaciones similares en paralelo. Una agrupación sobre millones de filas puede beneficiarse mucho, pero copiar datos y ejecutar operaciones no soportadas tiene un precio. La aceleración depende del tamaño y la forma del trabajo.
Más información en el link 👇

